
Строки и индексы
Чему вы научитесь:
- брать символ строки по номеру — с начала и с конца;
- вырезать из строки кусок с границами и шагом;
- объяснять, почему строку нельзя изменить, и получать новые строки методами;
- собирать текст из значений с помощью f-строк.
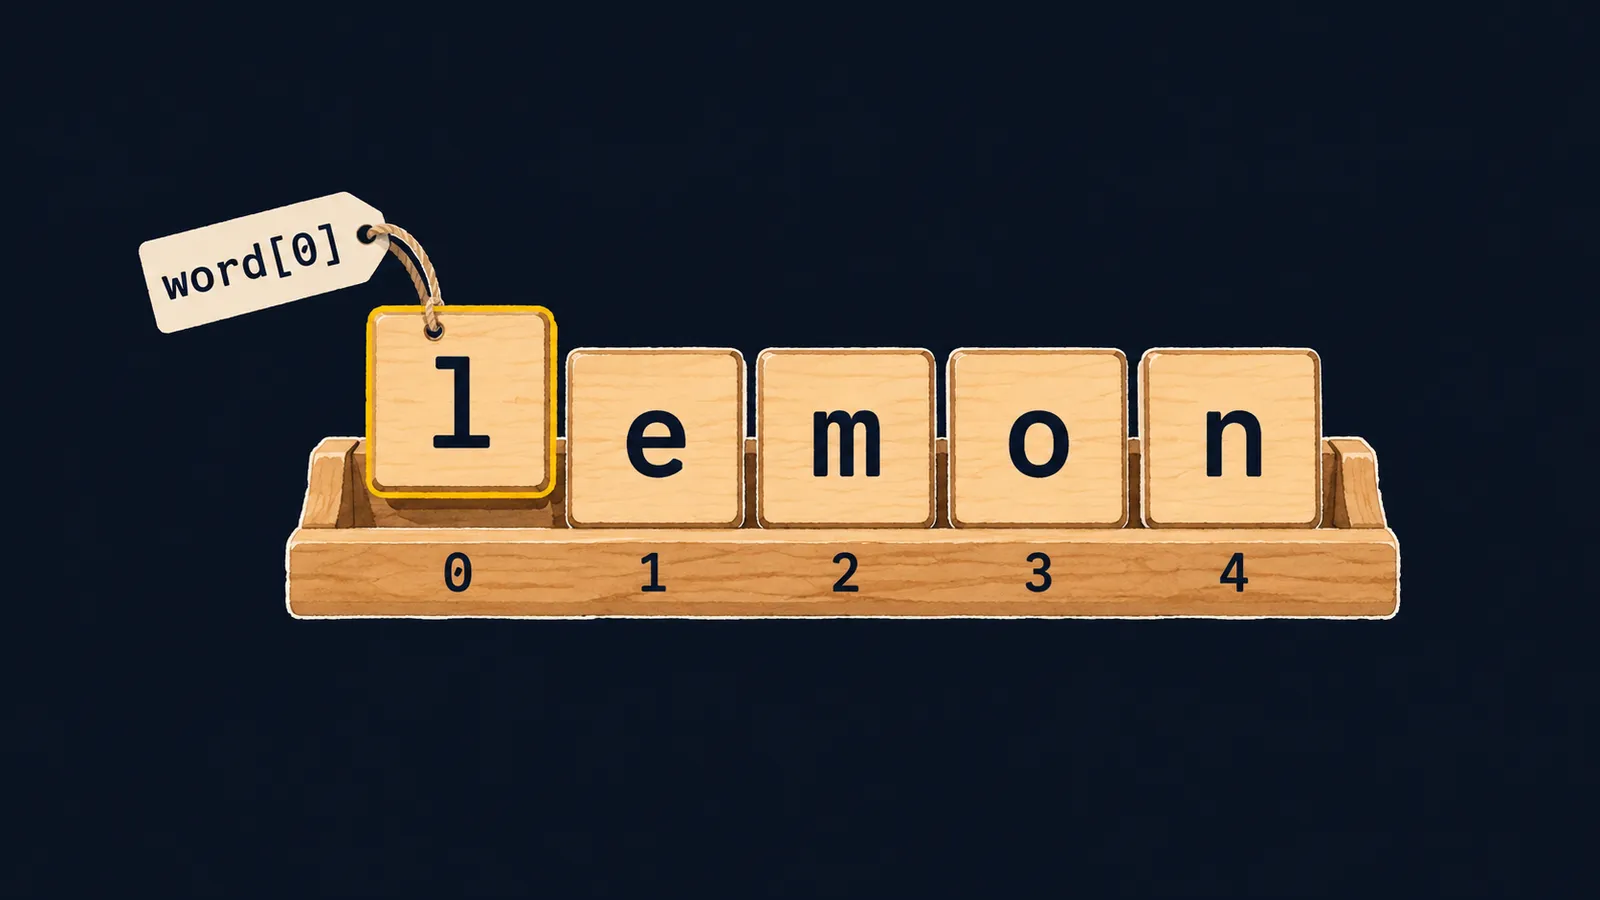
Представьте полочку с фишками для игры в слова. На ней стоят пять фишек с буквами l, e, m, o, n — получается слово lemon. Под каждой фишкой написан её номер: 0, 1, 2, 3, 4.
Чтобы взять первую фишку, вы называете её номер, и она поднимается над полочкой. На поднятой фишке висит бирка word[0]: так эту фишку называют в Python.
Строка в Python устроена так же. Она хранит символы по порядку, как фишки на полочке, и у каждого символа есть номер. Программе часто нужен один символ: первая буква имени, последняя цифра кода заказа. Номер нужного символа пишут в квадратных скобках после строки:
word = "lemon"
print(len(word))  # 5
print(word[0], word[1], word[4])  # l e n
print(word[-1], word[-5])  # n l
print("mon" in word, "Mon" in word)  # True False
Давайте разберём пример по строкам:
word = "lemon"связывает имяwordсо строкой из пяти символов.len(word)считает фишки на полочке: их5.word[0],word[1]иword[4]— первая, вторая и последняя буквы:l e n.word[-1]иword[-5]считают с правого края: последняя букваnи перваяl."mon" in wordпроверяет, стоят ли на полочке фишкиm,o,nподряд, а"Mon" in wordищет заглавнуюM.
Индекс
Номер символа в строке называют индексом. Счёт идёт с нуля: word[0] — первый символ, word[1] — второй.
Люди считают предметы с единицы, поэтому сначала это непривычно. Помогает такое правило: индекс показывает, сколько фишек стоит левее. Левее первой фишки нет ни одной, поэтому её индекс — 0.
Функция len возвращает длину строки — число символов в ней. Поэтому последний индекс на единицу меньше длины: в строке "lemon" из пяти символов это 4.
Что ещё важно знать об индексе:
word[0]возвращает строку из одного символа, типstr: её можно напечатать, сравнить или склеить с другой строкой;- пробел — тоже символ, и
len("a b")равно3; - у пустой строки
""длина0, и индексов у неё нет.
Строка — это последовательность: значения в ней стоят по порядку, и к каждому можно обратиться по индексу. Цикл for ch in word перебирает символы в том же порядке, от индекса 0 до последнего.
Здесь аналогия с полочкой заканчивается одной оговоркой. Фишку на полочке можно заменить другой, а символ в строке — нет. Строку можно читать по индексу, но не переписывать.
Отрицательные индексы
Часто нужен символ с конца: последняя цифра номера, последняя буква слова. Считать длину каждый раз неудобно, поэтому у символов есть вторая нумерация — справа налево.
Отрицательный индекс отсчитывает символы с конца: word[-1] — последний символ, word[-2] — предпоследний. Python заменяет отрицательный индекс i на len(word) + i. Поэтому word[-1] — то же, что word[len(word) - 1]. Самый левый отрицательный индекс — -len(word): в слове из пяти букв word[-5] — первая буква l.
Так последний символ берут, не считая длину:
code = "A-1047"
print(code[-1], code[-4])  # 7 1
print(code[len(code) - 1])  # 7
Разберём по строкам:
code[-1]— последний символ7, аcode[-4]— четвёртый с конца,1.code[len(code) - 1]даёт тот же7, но запись длиннее и её легче перепутать.
Этот вопрос часто задают на собеседовании: «Что вернут s[-1] и s[-len(s)]?» Ответ — последний и первый символы строки.
Оператор in
Выражение a in s проверяет, встречается ли строка a внутри s целиком: символ за символом, подряд. Результат — True или False.
Оператор in проверяет и один символ, и целое слово:
"e" in wordи"mon" in word— обаTrue;"mn" in word—False: обе буквы есть, но стоят не подряд;"Mon" in word— тожеFalse: регистр букв важен;"x" not in word—True:not inдаёт обратный ответ.
Частая ошибка
Последний символ берут по индексу, равному длине:
word = "lemon"
print(word[len(word)]) # ✗IndexError: string index out of rangeИндексы строки из пяти символов — от 0 до 4, и индекса 5 у неё нет. Python останавливает программу с ошибкой IndexError. Отрицательный индекс левее первого символа, например word[-6], даёт ту же ошибку. Последний символ — это word[len(word) - 1] или короче word[-1].
Главное
- Индекс — номер символа в строке; счёт идёт с нуля, последний индекс равен
len(s) - 1. - Отрицательный индекс считает с конца:
s[-1]— последний символ,s[-len(s)]— первый. - Индекс за пределами строки вызывает
IndexError. a in sпроверяет, стоит лиaвнутриsподряд, с учётом регистра.
Подпишись, чтобы пройти курс
Курс бесплатный. Войди через Telegram и подпишись на канал — откроются все уроки.
















